Lohnt sich Agenta? Ein zusätzlicher bestandener Prompt-Test reicht nicht für die Freigabe
Teams, die Prompts oft ändern und zur Prüfung weitergeben, können mit Agenta Versionen, Einzelergebnisse und Ausführungstraces vergleichen. Legen Sie kritische Fälle mit synthetischen Tests fest und rechnen Sie Prüfgewinn gegen Evaluierungs- und Wartungskosten.
Ein Team überarbeitet einen Support-Prompt, damit er häufige Fragen klarer beantwortet. Doch in einem Fall ohne Bearbeitungsnachweis steht im Entwurf: „Ihre Rückerstattung ist abgeschlossen.“ Wenn solche Änderungen häufig sind und eine andere Person sie prüfen muss, bündelt Agenta Versionen, Testergebnisse und Ausführungstraces. Ändern sich Prompts selten und lassen sich Probleme mit Repository und vorhandenen Offline-Tests bereits nachvollziehen, braucht es keine zusätzliche Plattform.
Versionsunterschiede an einzelnen Testfällen prüfen
Agenta beschreibt im Prompt- und Konfigurationsregister einen direkten Versionsvergleich und den Verlauf der Bereitstellungsumgebungen. Das Evaluierungsdashboard zeigt einzelne Eingaben, Ausgaben, Scores und die dazugehörigen Ausführungstraces. Prüfen Sie vor dem Test, ob die vorgesehene Version oder Bereitstellung das Evaluierungsdashboard, das Versionsregister und die nötigen Trace-Felder bietet. Ohne diese Bestätigung sollten Sie das Werkzeug nicht einführen. Vergleichen Sie in einer Testumgebung ohne echte Geschäftsberechtigungen den alten Prompt A und den neuen Prompt B anhand fester synthetischer Fälle. Halten Sie Modell, Parameter und Bewertungsregeln unverändert und ändern Sie nur den Prompt. Speichern Sie die Kennungen beider Versionen und die Version des Testsets, damit Kollegen Eingabe und aufgezeichnete Antwort wiederfinden. Damit ist keine wortgleiche Neugenerierung garantiert.
Nehmen Sie acht synthetische Fälle für Supportentwürfe. Angenommen, die alte Version besteht sechs und die neue sieben Fälle im selben Satz. Das ist ein hypothetisches Beispiel, kein Agenta-Testergebnis. Die neue Version behebt zwei alltägliche Antwortprobleme, meldet aber ohne Bestätigungsnachweis eine abgeschlossene Rückerstattung. Lassen Sie dies von einer Person als kritischen Fehler markieren und geben Sie die Version trotz höherer Gesamtzahl zur Überarbeitung zurück. Das Team legt die Schwelle vor Einsicht in die Ergebnisse fest. Formate können automatisch geprüft werden; unbestätigte geschäftliche Zusagen brauchen menschliche Prüfung. Bewerten Sie nur Entwürfe ohne Anbindung von Werkzeugen für Rückerstattungen oder den Versand externer Nachrichten. Ein bestandener Test ist keine Produktionsfreigabe.
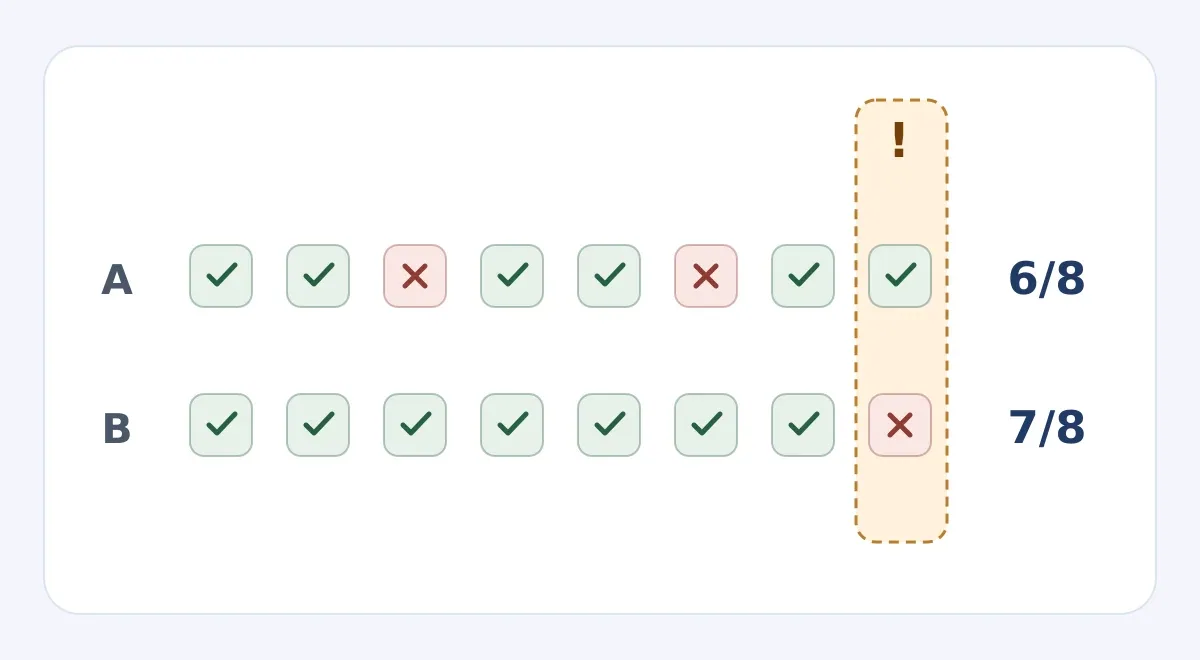
Fiktives Beispiel, kein Produktscreenshot und kein Testergebnis. Die gestrichelte Spalte markiert den vorab definierten kritischen Fall: Ohne Rückerstattungsbestätigung darf der Entwurf nicht behaupten, dass die Rückerstattung abgeschlossen ist. Trotz höherer Gesamtzahl geht B zur Überarbeitung zurück.
Mit einer Prüfungsübergabe über die Plattform entscheiden
Bitten Sie jemanden, der den Prompt nicht geändert hat, den Fehlerfall zu finden, beide Antworten zu prüfen und die Ursache anhand von Versionsunterschied und Trace zu ermitteln. Fehlen notwendige Zwischenschritte, ist ein vorhandener Trace allein keine Erklärung. Prüfen Sie, welche Testdaten und Trace-Felder gespeichert werden dürfen. Verwenden Sie nur synthetische Eingaben, keine Originalnachrichten von Kunden oder Produktionsschlüssel. Vergewissern Sie sich, dass die vorherige Konfiguration auffindbar ist, und üben Sie ihre Wiederherstellung in der Testumgebung. Ein Prompt-Rollback macht keine bereits ausgeführte externe Aktion rückgängig.
Ziehen Sie von der bei Diagnose und Übergabe gesparten Zeit die Testset-Pflege und zusätzliche manuelle Prüfung ab. Als Rechenbeispiel für Modellkosten: Acht Fälle mit zwei Versionen und drei Durchläufen pro Version ergeben 48 Entwürfe. Bewertet ein Modell jeden Entwurf, kommen 48 Bewertungsaufrufe hinzu. Drei Durchläufe sind eine Budgetannahme, keine Zuverlässigkeitsgarantie; kritische Fälle bleiben in menschlicher Prüfung. Generierung und Bewertung können bereits im alten Ablauf Kosten verursachen. Führen Sie diese gemeinsamen Kosten separat von zusätzlichen Plattform-, Integrations- und eigenen Hostingkosten auf.
Agenta nennt in seiner Open-Source-Ankündigung Evaluierung, Prompt-Verwaltung und Observability als offene Kernfunktionen. Einige erweiterte Funktionen wie rollenbasierter Zugriff, Single Sign-on und Audit-Protokolle sind separat lizenziert. Prüfen Sie auch beim Selbsthosting, welche Governance-Funktionen Sie benötigen. Weiten Sie den Einsatz nur aus, wenn kritische Fälle zuverlässig bleiben, andere die gespeicherten Eingaben und Ergebnisse nachvollziehen können und die eingesparte Zeit die Mehrkosten deckt. Fehlt vor allem Testabdeckung für echte Risiken, ergänzen Sie zuerst das Testset, statt das Werkzeug zu wechseln.
Hinweis zum Inhalt:Dieser Artikel basiert auf öffentlich verfügbaren Informationen und dient als Orientierung bei der Auswahl von Tools. Funktionen, Preise und zugehörige Richtlinien können sich jederzeit ändern; maßgeblich sind die aktuellen offiziellen Angaben.
Originalquelle:www.agenta.ai