Arthur: Lohnt die Überwachung falscher Labels?
Sechs fiktive Fälle trennen Fehlalarme, übersehene Fehler und echte Treffer.
Für feste Formate reichen Regeln und Stichproben. Arthur kommt infrage, wenn mehrere Versionen mit derselben Bewertungsregel verglichen werden. Offizielle Notizen nennen im September 2025 eigene Evaluierungen, im Juli 2026 Erfolgsraten und Einzelstatus. Eine Quote ersetzt keine Fehleranalyse. (Quelle)
Sechs fiktive Bastelkatalog-Einträge: drei Labels sind falsch, drei korrekt. Zwei Fehler erkannt (TP), ein korrektes Label alarmiert (FP), ein Fehler verpasst (FN), zwei korrekte freigegeben (TN). 2/3 aller Fehler erkannt und 2/3 aller Alarme berechtigt: gleiche Zahl, andere Nenner.
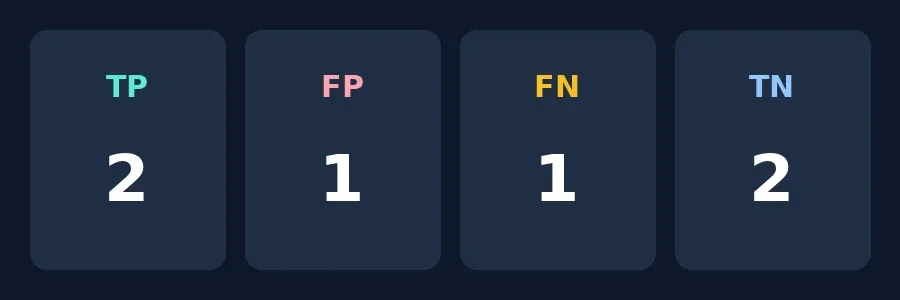
Eigene Grafik, kein Arthur-Test. Fehlalarme und Auslassungen zählen beide.
Nur beobachten, Einzelfälle mit der Begründung prüfen und keine echten Daten nutzen. Sechs Beispiele belegen keine stabile Genauigkeit. Geänderte Kriterien an separaten Fällen prüfen. Wenn Pflichtfehler fehlen oder Fehlalarme die Ersparnis aufzehren, nicht automatisieren. Monitoring nur, wenn es nötige Fehler findet und Prüfer den Datensatz sehen können; kein automatisches Blockieren.
Hinweis zum Inhalt:Dieser Artikel basiert auf öffentlich verfügbaren Informationen und dient als Orientierung bei der Auswahl von Tools. Funktionen, Preise und zugehörige Richtlinien können sich jederzeit ändern; maßgeblich sind die aktuellen offiziellen Angaben.
Originalquelle:www.arthur.ai