BestLLMfor-Auswahlhilfe: VRAM-Spielraum für zwei Kontextlängen prüfen
Öffentliche Daten ergeben eine Vorauswahl, keine Hardwaregarantie. Zwei fiktive Budgets trennen Gewichte, Kontext und Laufzeitbedarf.
Zur Vorauswahl nutzen, nicht als Benchmark
BestLLMfor sortiert im GPU-Ratgeber vom August 2026 nach VRAM-Klassen und prüft dann Modell und Quantisierung. Seine Quantisierungserklärung trennt Modellgewichte vom KV-Cache, der mit dem Kontext wächst. So lassen sich vergleichbare Textmodelle vorfiltern. Kompatibilität, Geschwindigkeit und Antwortqualität auf dem eigenen Gerät sind damit nicht bestätigt. Das maximale Kontextfenster eines Modells ist nicht dasjenige, das der eigene Rechner verkraftet.
Für dasselbe Modell zweimal rechnen
Auf einer fiktiven 8-GB-Karte bleiben 1 GB für System und andere Programme frei, also beträgt das Budget 7 GB. Kandidat A nutzt eine feste Quantisierung. Angenommen, Gewichte brauchen 5 GB und die Laufzeit 0,5 GB. Für kurze Eingaben kommen 0,8 GB Cache hinzu: 6,3 GB gesamt, 0,7 GB frei. Bei langen Eingaben sind es 2 GB Cache: 7,5 GB gesamt, 0,5 GB zu viel. Die Werte erklären nur die Berechnung und sind keine echten Produktdaten.
Vergleicht ein ähnliches Textmodell B bei gleicher Eingabelänge, gleichem Ausgabelimit und gleicher Laufzeitumgebung. Erfasst die Quantisierung von A und B separat. Vergleicht nicht kurze Eingaben für A mit langen für B. Die Vorauswahl zeigt, dass A im kurzen Fall passt, im langen nicht. Als Nächstes kann man eine leichtere Quantisierung, kürzere Dokumente oder ein kleineres Modell gleichen Typs prüfen. Die Rechnung sagt nicht, wer besser antwortet.
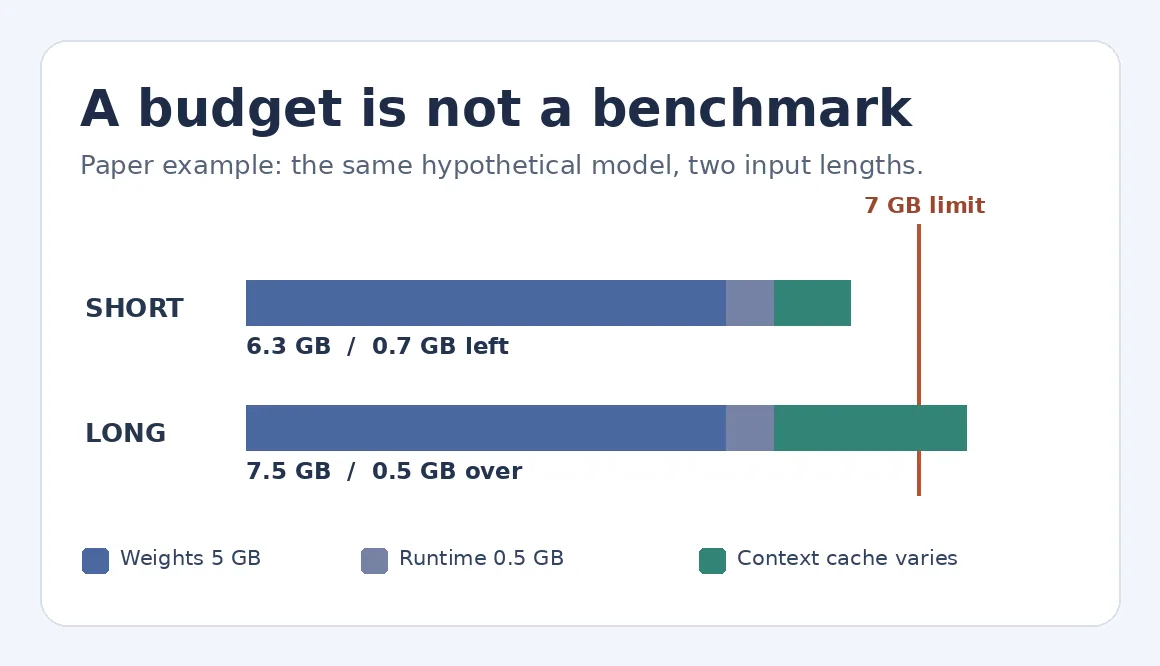
Eigene Papiergrafik. Gewichte und Laufzeitbedarf bleiben gleich; nur der Kontextcache ändert sich. Eine Budgetüberschreitung misst keine Leistung.
Wann die Schätzung nicht für die Entscheidung reicht
Wenn Modell, Laufzeitumgebung oder Quantisierung unklar sind, sollte die Schätzung keinen Hardwarekauf begründen. Bei vorwiegend kurzen Texten und einer bereits ausreichend schnellen Lösung ist das vorhandene Werkzeug oft einfacher als ein zusätzlich gepflegtes lokales Modell. Bei langen Dokumenten sollten freier VRAM, Trefferquote auf eigenen Blättern und Wartezeit separat geprüft werden. Erstellt einen fiktiven Katalog, Aufgaben mit bekannten Antworten und ein vorher festgelegtes Zeitlimit. Die Schätzung reduziert nur die Kandidatenliste. Es wird kein Modell heruntergeladen und keine Software ausgeführt.
Hinweis zum Inhalt:Dieser Artikel basiert auf öffentlich verfügbaren Informationen und dient als Orientierung bei der Auswahl von Tools. Funktionen, Preise und zugehörige Richtlinien können sich jederzeit ändern; maßgeblich sind die aktuellen offiziellen Angaben.
Originalquelle:bestllmfor.com