¿Vale la pena adoptar Agenta? Superar una prueba más no basta para publicar un prompt nuevo
Los equipos que modifican prompts a menudo y los entregan a otra persona para revisión pueden comparar versiones, resultados por caso y trazas con Agenta. Define los casos críticos con pruebas sintéticas y compara el valor de la revisión con el coste de evaluar y mantener el sistema.
Un equipo modifica un prompt de atención al cliente. Las respuestas frecuentes quedan más claras, pero un borrador dice «El reembolso está completado» cuando no hay constancia de que se haya tramitado. Si estos cambios son frecuentes y debe revisarlos otra persona, el valor de Agenta está en reunir versiones, resultados y trazas de ejecución. Si los prompts apenas cambian y el repositorio y las pruebas fuera de producción ya permiten rastrear los problemas, no hace falta añadir una plataforma.
Relaciona las diferencias entre versiones con casos concretos
El registro de prompts y configuraciones de Agenta permite comparar versiones en paralelo y guarda el historial de entornos de despliegue. El panel de evaluación muestra la entrada, salida, puntuación y traza de cada caso. Antes de probar, comprueba que la versión o el despliegue que quieres utilizar da acceso al panel, al registro y a los campos de traza necesarios. Si no puedes confirmarlo, no lo adoptes. En un entorno sin permisos operativos reales, compara el prompt anterior A y el nuevo B con casos sintéticos fijos. Mantén el modelo, los parámetros y las reglas de evaluación; cambia solo el prompt. Registra los identificadores de ambas versiones y la versión del conjunto de prueba para recuperar la misma entrada y la respuesta guardada. Eso no garantiza que el modelo vuelva a responder palabra por palabra igual.
Prepara ocho casos sintéticos de borradores de atención al cliente. Supón que con el mismo conjunto la versión anterior supera seis y la nueva, siete. Es un ejemplo hipotético, no un resultado medido en Agenta. La nueva resuelve dos problemas habituales, pero dice que se completó un reembolso sin constancia de confirmación. Pide a una persona que lo marque como fallo crítico y devuelve el prompt para corregirlo aunque suba el total. El equipo debe fijar ese criterio antes de ver los resultados. El formato se puede comprobar automáticamente, pero una promesa comercial sin confirmar requiere revisión humana. Evalúa solo borradores, sin conectar herramientas de reembolso ni de envío externo. Superar la evaluación no autoriza el despliegue en producción.
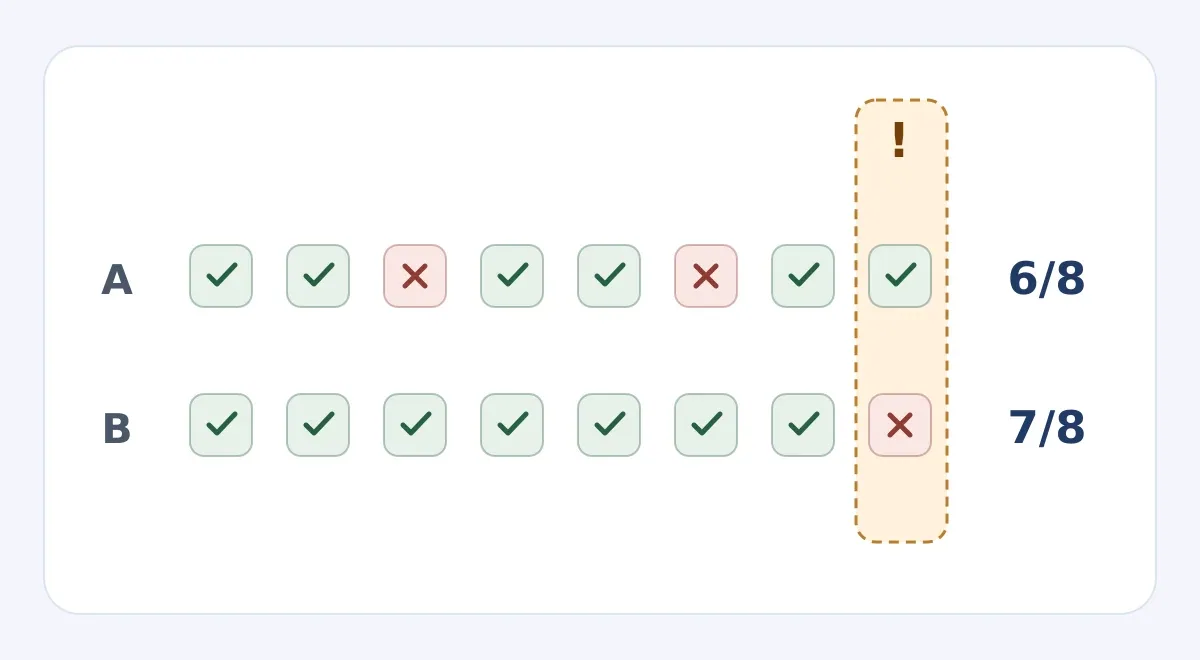
Ejemplo ficticio, no una captura de la herramienta ni un resultado de prueba. La columna discontinua señala el caso crítico definido de antemano: sin confirmación, el borrador no puede afirmar que el reembolso se completó. La persona que revisa devuelve B aunque su total sea mayor.
Prueba el traspaso de la revisión antes de elegir la plataforma
Pide a alguien que no modificó el prompt que encuentre el caso fallido, compruebe ambas respuestas y localice el problema con las diferencias de versión y la traza. Si la traza no incluye los detalles intermedios necesarios, tenerla no basta para explicar el error. Comprueba qué datos de prueba y campos de traza se pueden guardar. Usa solo entradas sintéticas, no mensajes originales de clientes ni claves de producción. Comprueba que puedes localizar la configuración anterior y ensaya su restauración en el entorno de pruebas. Restaurar el prompt no deshace acciones externas ya realizadas.
Resta al tiempo ahorrado en diagnóstico y traspaso el mantenimiento del conjunto y la revisión humana adicional. Para estimar el presupuesto del modelo, ocho casos en dos versiones con tres rondas por versión dan 48 borradores. Si un modelo puntúa cada borrador, añade 48 llamadas de evaluación. Las tres rondas son un supuesto de presupuesto, no una garantía de fiabilidad; las personas siguen revisando los casos críticos. La generación y la puntuación pueden ser costes comunes al método anterior. Sepáralos de los costes añadidos de plataforma, integración o alojamiento propio.
El anuncio de código abierto de Agenta incluye la evaluación, la gestión de prompts y la observabilidad entre sus funciones abiertas esenciales, pero separa la licencia de ciertas funciones avanzadas de colaboración, como el acceso por roles, inicio de sesión único y registros de auditoría. Aunque lo alojes tú, verifica las funciones de gobernanza necesarias. Amplía el uso solo si los casos críticos siguen superándose, otra persona puede recuperar entradas y resultados guardados y el valor del tiempo ahorrado cubre el coste adicional. Si faltan pruebas para riesgos reales, amplía el conjunto antes de cambiar de herramienta.
Nota sobre el contenido:Este artículo se basa en información pública y sirve como referencia para comparar y elegir herramientas. Las funciones, los precios y las políticas relacionadas pueden cambiar en cualquier momento; consulta la información oficial más reciente.
Fuente original:www.agenta.ai