Arthur: ¿vale la pena vigilar etiquetas incorrectas?
Seis casos ficticios separan detecciones, falsas alarmas y errores omitidos.
Para un formato fijo, reglas y muestreo manual suelen bastar. Considera Arthur si varias versiones comparten un criterio de evaluación. Las notas de septiembre de 2025 confirman evaluaciones personalizadas y las de julio de 2026, tasas y estados por caso. Una tasa no reemplaza revisar errores. (Fuente)
Seis registros ficticios de papel: tres etiquetas erróneas y tres correctas. Supón dos errores detectados TP, una falsa alarma FP, un error omitido FN y dos correctas sin alerta TN. Detecta 2/3 de errores y acierta en 2/3 de las alertas: misma cifra, distinto denominador.
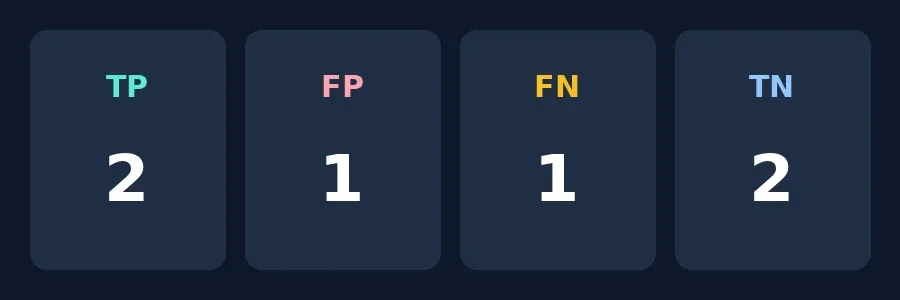
Diagrama propio, no medición de Arthur. Revisa alarmas falsas y errores omitidos.
Mantén solo observación y coteja la justificación, sin tráfico real. Seis ejemplos no prueban precisión estable. Cambia criterios y prueba casos aparte. Si omite un error imprescindible o las alertas consumen el tiempo ahorrado, no automatices. Añade supervisión si localiza errores necesarios y el registro concreto; sin bloqueo automático.
Nota sobre el contenido:Este artículo se basa en información pública y sirve como referencia para comparar y elegir herramientas. Las funciones, los precios y las políticas relacionadas pueden cambiar en cualquier momento; consulta la información oficial más reciente.
Fuente original:www.arthur.ai