Faut-il adopter Agenta ? Réussir un test de plus ne suffit pas à publier un nouveau prompt
Les équipes qui modifient souvent leurs prompts et délèguent leur vérification peuvent comparer versions, résultats par cas et traces dans Agenta. Définissez les cas critiques avec des tests synthétiques, puis comparez le bénéfice de la revue aux coûts d’évaluation et de maintenance.
Une équipe améliore le prompt de réponse du support. Les réponses aux questions courantes deviennent plus claires, mais un brouillon affirme « Votre remboursement est terminé » sans trace de traitement. Si les changements sont fréquents et qu’un autre collègue doit les vérifier, Agenta réunit versions, résultats et traces d’exécution. Si les prompts changent rarement et que votre dépôt et vos tests hors ligne permettent déjà de retrouver les problèmes, une autre plateforme est superflue.
Relier les différences de version à des cas précis
Le registre des prompts et des configurations d’Agenta compare les versions côte à côte et conserve l’historique des environnements de déploiement. Le tableau d’évaluation présente les entrées, les sorties, les scores et les traces qui ont produit ces sorties pour chaque cas. Avant l’essai, confirmez que la version ou le déploiement visé donne accès au tableau de bord, au registre et aux champs de trace nécessaires. Sinon, n’adoptez pas l’outil. Sans droits opérationnels réels, comparez l’ancien prompt A au nouveau B sur des cas synthétiques fixes. Conservez modèle, paramètres et règles d’évaluation, en ne changeant que le prompt. Notez les identifiants des deux versions et la version du jeu de test pour qu’un collègue retrouve l’entrée et la réponse enregistrée. Cela ne garantit pas une nouvelle réponse mot pour mot identique.
Prenez huit cas synthétiques de brouillons de support. Supposons que sur le même jeu, l’ancienne version réussisse six cas et la nouvelle sept. C’est une hypothèse, pas un résultat mesuré dans Agenta. La nouvelle corrige deux réponses courantes, mais affirme qu’un remboursement est terminé alors qu’aucune confirmation n’existe. Demandez à une personne de le marquer comme échec critique et renvoyez la version à corriger malgré le meilleur total. L’équipe fixe ce seuil avant de voir les résultats. Le format peut être contrôlé automatiquement, mais les promesses commerciales non confirmées exigent une revue humaine. Évaluez uniquement les brouillons, sans connecter d’outil de remboursement ou d’envoi externe. La réussite n’autorise pas une mise en production.
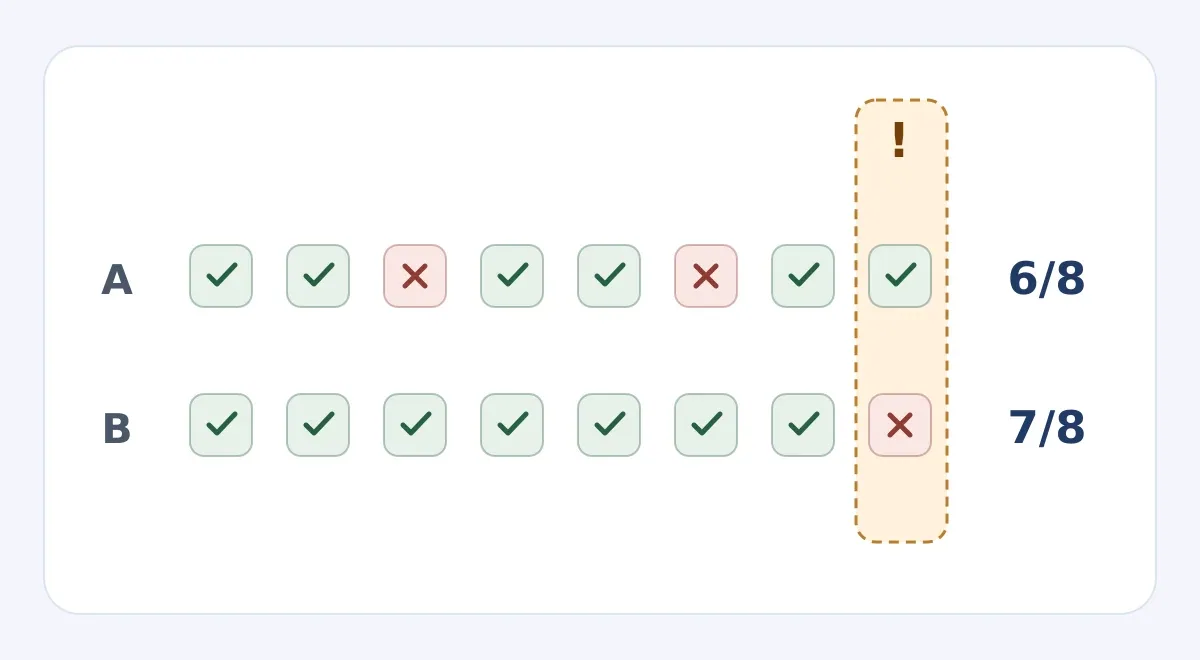
Schéma fictif, ni capture du produit ni résultat de test. La colonne en pointillé signale le cas déclaré critique à l’avance : sans confirmation, le brouillon ne doit pas annoncer un remboursement terminé. Le responsable renvoie B à corriger malgré son total supérieur.
Tester une passation avant de choisir la plateforme
Demandez à quelqu’un qui n’a pas modifié le prompt de retrouver le cas en échec, de vérifier les deux réponses et de localiser le problème avec les différences de version et la trace. Si la trace ne contient pas les détails intermédiaires nécessaires, sa présence n’explique pas l’erreur. Vérifiez quelles données et quels champs de trace peuvent être stockés. Utilisez uniquement des entrées synthétiques, sans messages clients originaux ni clés de production. Assurez-vous de retrouver la configuration précédente et exercez-vous à la rétablir en test. Rétablir un prompt n’annule pas une action externe déjà exécutée.
Déduisez l’entretien du jeu de test et la revue humaine supplémentaire du temps gagné sur le diagnostic et la passation. Pour estimer le budget modèle, prenez huit cas, deux versions et trois exécutions par version : 48 brouillons générés. Si un modèle note chaque brouillon, comptez 48 appels de notation de plus. Trois exécutions sont une hypothèse budgétaire, pas une garantie de fiabilité ; les cas critiques restent revus par une personne. La génération et la notation peuvent déjà coûter dans l’ancien processus. Séparez ces coûts communs des frais supplémentaires de plateforme, d’intégration ou d’auto-hébergement.
L’annonce open source d’Agenta inclut l’évaluation, la gestion des prompts et l’observabilité dans les fonctions de base ouvertes, mais place certaines fonctions de collaboration avancées, comme les droits par rôle, l’authentification unique et les journaux d’audit, sous licence distincte. L’auto-hébergement ne dispense pas de vérifier ces fonctions de gouvernance. Étendez l’usage seulement si les cas critiques restent couverts, si d’autres peuvent retrouver les entrées et résultats enregistrés et si le temps gagné couvre les coûts supplémentaires. Si le problème principal est un manque de couverture des risques réels, complétez le jeu de test avant de changer d’outil.
À propos de cet article :Cet article s’appuie sur des informations publiques et sert de référence pour vous aider à choisir vos outils. Les fonctionnalités, les tarifs et les politiques associées peuvent évoluer à tout moment ; veuillez consulter les informations officielles les plus récentes.
Source originale :www.agenta.ai