Choisir Analyzr : un tableau importable peut encore contenir des informations futures
Analyzr porte désormais la marque G2M. Il convient aux équipes qui prédisent régulièrement et peuvent maintenir des entrées cohérentes. Avant de choisir, vérifiez l’index, la cible et la date limite sur des événements fictifs : des noms de colonnes acceptés ne prouvent pas l’absence de fuite d’informations futures.
Une équipe qui organise régulièrement de petites présentations de produit peut vouloir estimer le nombre de documents à imprimer sans réécrire du code de modèle à chaque fois. L’approche sans code d’Analyzr peut être utile, mais le critère d’achat ne se résume pas à importer un CSV et exporter les résultats. Il faut pouvoir fournir, pour l’événement suivant, des entrées définies de la même façon. Analyzr a officiellement adopté la marque G2M : consultez G2M Platform pour les fonctions et le périmètre livré, sans considérer l’ancien nom comme un service indépendant.
Le guide des variables de G2M distingue plusieurs rôles : les variables indépendantes sont les entrées, la variable dépendante d’une régression est la cible numérique, et l’index identifie les enregistrements pendant l’importation, l’entraînement et la prédiction. Un type non détecté automatiquement doit être défini manuellement. Pour estimer la fréquentation, l’identifiant E17 relie le résultat à son enregistrement, le nombre réel de participants est la cible et les inscriptions connues à l’avance peuvent être une entrée. Un identifiant utile au rapprochement ne doit pas, pour cette seule raison, devenir un prédicteur. Un type correct ne prouve pas non plus que la valeur était disponible au moment de décider.
Un même nom de colonne peut recouvrir deux moments différents
Commencez avec des données entièrement fictives : l’événement E17 compte 120 inscriptions sept jours avant sa tenue, 150 inscriptions finales le jour même et 96 participants réels. Si l’équipe choisit la quantité à imprimer sept jours avant, elle peut utiliser les 120 connus alors, mais pas regarder les 150 futurs. Dans un tableau historique d’entraînement, les 96 enregistrés après l’événement peuvent servir de cible. Ils ne doivent pas davantage se retrouver parmi les entrées disponibles sept jours avant. Il ne s’agit ni d’exécuter un modèle ni d’affirmer que ces champs suffisent à prédire, mais de préciser quand chaque valeur peut être connue.
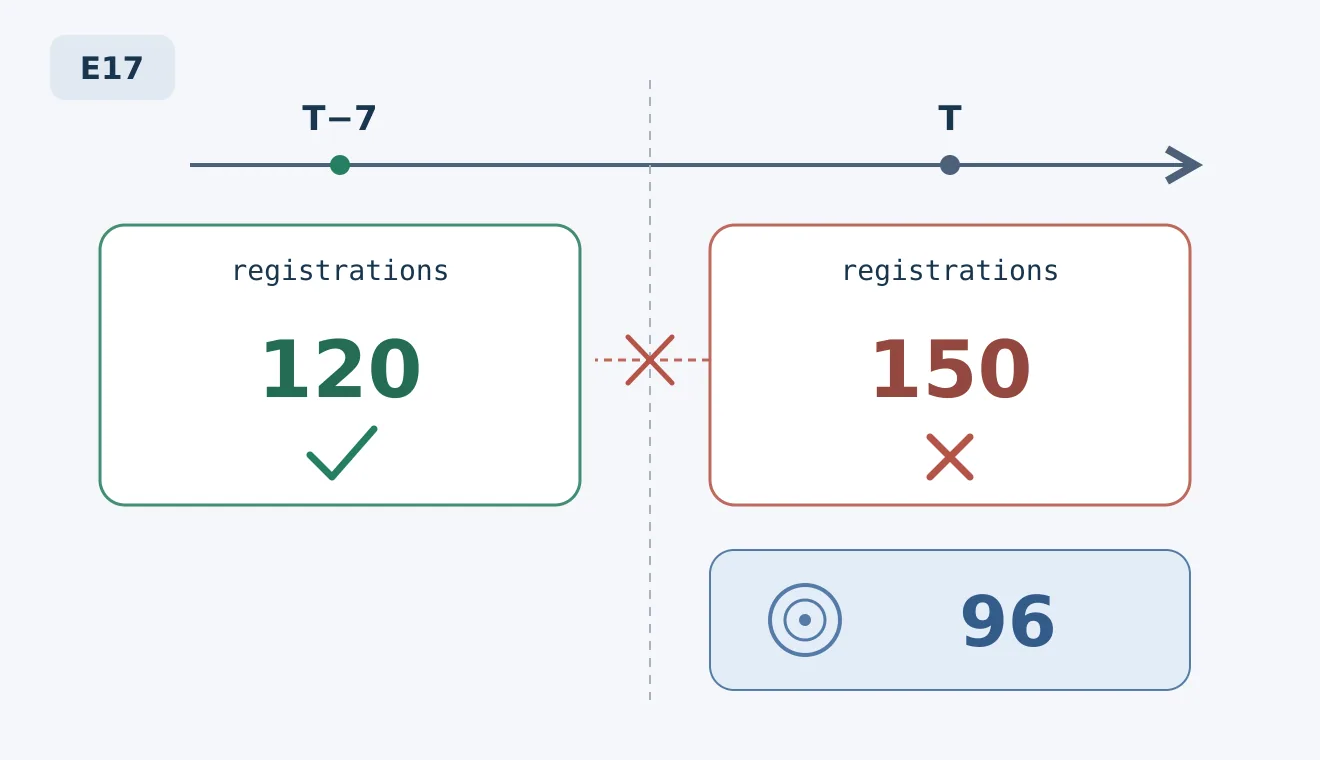
Exemple fictif original, pas une sortie de modèle Analyzr ou G2M. T est le jour de l’événement. 120 et 150 peuvent figurer dans une colonne registrations, mais deviennent disponibles à des moments différents. La présence réelle de 96 est la cible d’entraînement historique, pas une entrée connue sept jours avant.
Les instructions G2M pour prédire avec un modèle existant exigent les mêmes variables sélectionnées à l’entraînement, avec des noms de colonnes identiques dans le CSV. Les colonnes supplémentaires non utilisées sont acceptées ; une variable requise manquante déclenche une erreur. Ce contrôle aide à détecter une incohérence de structure, sans vérifier à la place de l’équipe le sens temporel des données. Si registrations désigne les 150 inscriptions finales dans la table d’entraînement et les 120 à sept jours pour l’événement suivant, les noms peuvent être identiques tout en recouvrant des notions différentes. Faites de la capture des inscriptions sept jours avant une condition explicite de livraison des données. Introduisez volontairement des valeurs connues plus tard dans quelques lignes fictives pour voir comment le prétraitement les détecte ou les bloque, au lieu de supposer une protection automatique de la plateforme.
Relier le résultat à l’événement avant de choisir une plateforme
La documentation décrit le chargement d’un CSV dans Predict, la consultation des résultats et leur exportation. Pour des prédictions machine à machine continues depuis un système source, il faut contacter le responsable de compte ou le support. À l’achat, distinguez l’importation manuelle par lots du fonctionnement automatisé continu. Pouvoir exporter ne signifie pas que l’intégration, la fréquence de mise à jour et l’exploitation sont incluses. Vérifiez d’abord avec des identifiants fictifs à quel événement, à quel instantané d’entrée et à quelle version du modèle correspond chaque prédiction exportée. Ne comptez pas sur un ordre de lignes resté intact par hasard et ne prenez pas une répétition sur des données d’exemple pour une validation de performance.
La performance doit être évaluée séparément. Définissez le modèle et une référence simple uniquement à partir des données historiques d’entraînement. La référence peut, par exemple, multiplier le taux de présence d’événements antérieurs comparables par les inscriptions à sept jours. Comparez ensuite les erreurs sur des événements plus récents qui n’ont pas servi au choix. Les deux méthodes ne doivent utiliser que les entrées connues à la même date limite. Comparez le travail à refaire et le gaspillage dus à une impression insuffisante ou excessive, plutôt qu’une seule erreur globale séduisante. C’est une validation à concevoir par l’équipe, non une méthode par défaut vérifiée de la plateforme. Avec peu d’exemples ou des définitions d’événement changeantes, consigner les instantanés et les résultats réels dans un tableur est généralement plus pragmatique.
L’achat se justifie si la prédiction est récurrente, si l’équipe peut prendre en charge les instantanés d’entrée et les exceptions, et si le temps économisé en modélisation et en transmission couvre l’utilisation, la configuration des connexions et la maintenance continue figurant au devis. Demandez au fournisseur de préciser séparément les livrables du traitement CSV par lots, de l’intégration de prédictions continues et de la traçabilité des versions, puis comparez-les au processus actuel sur tableur. Envisagez d’étendre l’usage seulement si les résultats sont traçables par identifiant, si les entrées d’entraînement et de prédiction ont le même sens temporel et si les erreurs respectent le seuil convenu d’avance. Les événements fictifs de cet article servent à préparer des documents, pas à décider de l’éligibilité de personnes, de questions financières ou d’autres sujets à fort impact.
À propos de cet article :Cet article s’appuie sur des informations publiques et sert de référence pour vous aider à choisir vos outils. Les fonctionnalités, les tarifs et les politiques associées peuvent évoluer à tout moment ; veuillez consulter les informations officielles les plus récentes.
Source originale :g2m.ai