Bien choisir avec BestLLMfor : vérifiez la marge de VRAM sur deux longueurs
Les spécifications publiques aident à présélectionner, pas à garantir le matériel. Deux budgets fictifs séparent poids, contexte et surcoût d’exécution.
Présélectionner, et non mesurer les performances
Le guide GPU de BestLLMfor d’août 2026 présélectionne les modèles selon la VRAM, puis distingue modèle et quantification. L’explication de la quantification sépare les poids du cache KV, qui croît avec le contexte. Cela aide à filtrer des modèles textuels comparables, sans confirmer leur compatibilité, leur vitesse ou la qualité des réponses sur votre machine. Le contexte maximal annoncé n’est pas forcément celui que votre machine peut absorber.
Calculer deux budgets pour le même modèle
Sur une carte fictive de 8 Go, réservez 1 Go au système et aux autres programmes : il reste 7 Go. Avec une quantification fixe pour le candidat A, supposez 5 Go de poids et 0,5 Go de surcoût d’exécution. Une entrée courte avec 0,8 Go de cache donne 6,3 Go au total et 0,7 Go de marge. Une longue avec 2 Go de cache donne 7,5 Go, soit 0,5 Go de trop. Ces chiffres servent à illustrer, pas à décrire un modèle ou un matériel réels.
Comparez le modèle textuel B avec la même longueur d’entrée, le même budget de sortie et le même environnement. Notez séparément les quantifications de A et de B. N’opposez pas une entrée courte pour A à une longue pour B. Le premier filtre montre que A entre dans le budget dans le cas court mais pas dans le long. On peut ensuite comparer une quantification plus légère, raccourcir les documents ou choisir un modèle similaire plus petit. Cela n’identifie pas le meilleur modèle en qualité.
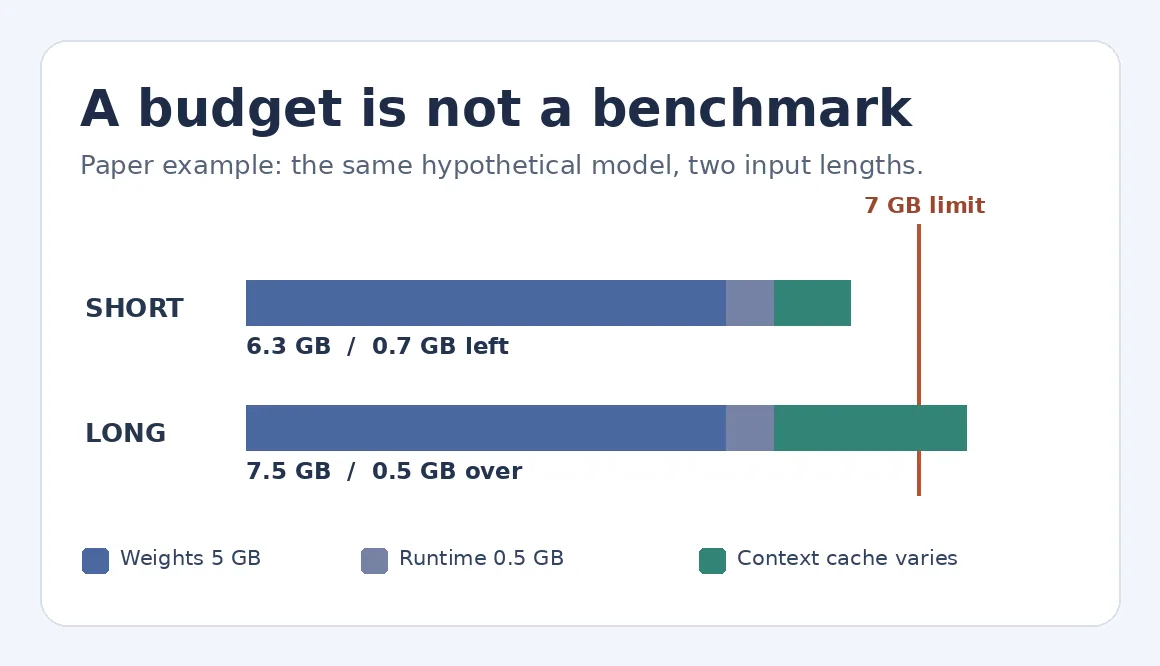
Schéma original sur papier. Poids et surcoût d’exécution restent fixes ; seul le cache de contexte change. Dépasser le budget ne mesure pas les performances.
Quand ne pas décider sur cette base
Si le modèle, l’environnement ou la quantification ne sont pas précisés, n’achetez pas de matériel sur la foi de l’estimation. Pour des textes courts, un outil existant assez rapide peut coûter moins d’efforts qu’un modèle local à gérer. Pour les documents longs, contrôlez séparément VRAM restante, taux de bonnes réponses sur des feuilles maison et attente. Rédigez un catalogue fictif, des questions à réponse connue et une limite d’attente préalable. L’estimation sert juste à réduire la liste à vérifier. Ici, aucun modèle n’est téléchargé et aucun logiciel n’est exécuté.
À propos de cet article :Cet article s’appuie sur des informations publiques et sert de référence pour vous aider à choisir vos outils. Les fonctionnalités, les tarifs et les politiques associées peuvent évoluer à tout moment ; veuillez consulter les informations officielles les plus récentes.
Source originale :bestllmfor.com