BestLLMfor の選定ガイド:二つのコンテキスト長で VRAM の余裕を確認
公開仕様は候補を絞る材料であって動作保証ではない。二種の架空の予算で重み、コンテキスト、実行時の負荷を分けて見る。
ベンチマークではなく候補の絞り込みに
BestLLMfor の 2026 年 8 月の GPU 選定ガイドは VRAM 容量から候補を選び、モデルと量子化を個別に確認する。量子化の解説は重みと、コンテキストに応じて増える KV キャッシュを分ける。同種のテキストモデルを絞るには便利だが、手元の機器での互換性、速度、回答品質を保証しない。モデルの最大コンテキストと実機で使える長さは別物だ。
同じモデルを二通りで試算する
架空の 8 GB カードからシステムと他のアプリ用に 1 GB を残すと、予算は 7 GB。候補 A の量子化は固定し、重み 5 GB、実行時負荷 0.5 GB と仮定する。短い入力のキャッシュが 0.8 GB なら合計 6.3 GB で余り 0.7 GB。長い入力のキャッシュが 2 GB なら合計 7.5 GB で 0.5 GB 超過する。数値は説明用で実機やモデルの仕様ではない。
同種の候補 B と比べるなら、入力長、出力の上限、実行環境をそろえ、A と B の量子化はそれぞれ記録する。A の短文と B の長文を比べない。一次選定で分かるのは A が短文なら収まり長文では超えること。より軽い量子化、短い文書、小型の同種モデルを次に検討する。回答の優劣はこの計算から決まらない。
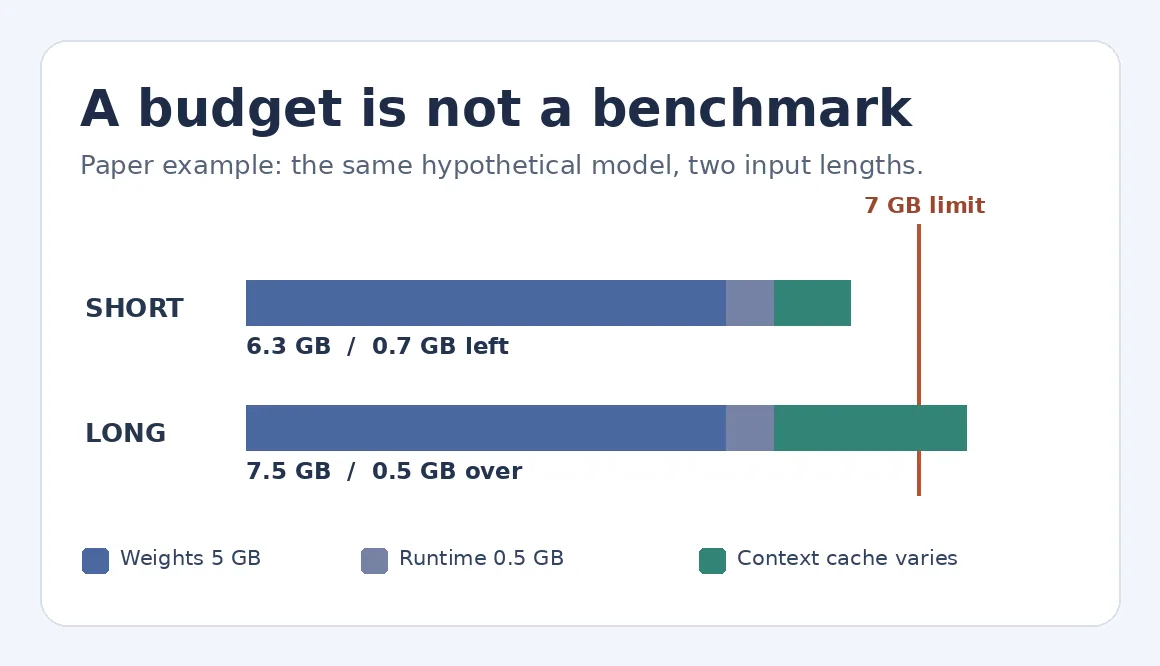
オリジナルの紙上例。重みと実行時負荷は固定で、コンテキストのキャッシュだけが変わる。予算超過は性能測定ではない。
推定だけで決めない場面
モデル、実行環境、量子化が曖昧なら、ページの数字で機材を買わない。短い文章が中心で既存の方法が十分速いなら、本体を管理するより現在の道具が簡単なこともある。長文が必須なら、空き VRAM、自作サンプルの正答率、待ち時間を別々に判定する。架空の目録を自作し、答えのある検索問題を数問と、待てる時間の上限を決める。推定は確かめる候補を絞るだけで、ここではダウンロードもソフトの実行もしない。
内容説明:本記事は公開情報をもとに整理した、ツール選定の参考情報です。機能、料金、関連ポリシーは随時変更される場合があります。最新の公式情報をご確認ください。
元の出典:bestllmfor.com