Agenta 值得采用吗?提示词新版本多过一题,也可能不该上线
经常改提示词、需要交给另一位同事复核的团队,可以用 Agenta 对照版本、逐例结果与运行链路。先用合成测试设定不能退步的关键用例,再算复核收益能否覆盖维护和评估成本。
团队改了客服回复提示词,常见问题的答复更清楚,但某个缺少处理记录的案例却被写成了「退款已完成」。如果这种改动频繁、又需要另一位同事复核,Agenta 的价值在于把版本、测试结果与运行链路放在一起看。若提示词很少改,版本库里的配置与现有离线测试已经能追溯问题,就不必再引入一套平台。
把新旧版本的差异落到具体用例
Agenta 发布的提示词与配置注册表支持并排比较版本,并记录部署环境的历史;评估面板能查看单条输入、输出、分数和生成该输出的运行链路。试用前先确认拟用的版本或部署能访问评估面板、版本注册表和所需的链路字段;无法确认就不要选。再在没有真实业务权限的环境里,用固定的合成用例对照旧版 A 和新版 B。锁定模型、参数及评估规则,只改提示词。评估记录里保存两版的标识与测试集版本,让复核同事能找到同一个输入和当时保存的回答,而不是在聊天记录里找一张分数截图;这不保证重跑时逐字相同。
试做八条客服草稿用例。假设在同一固定测试集里,旧版通过 6 条、新版通过 7 条。这不是 Agenta 实测:新版修正两处普通答复问题,却在「没有退款确认记录」这条用例上说退款已经完成。验收时,这条应由人工标为关键失败;即使总分提高,也先退回新版。这样的门槛要在看结果前写好。格式可以自动判定,未经确认的业务承诺应由人复核。评估只看草稿,不连接退款或对外发信工具,也不把通过评估当成正式上线许可。
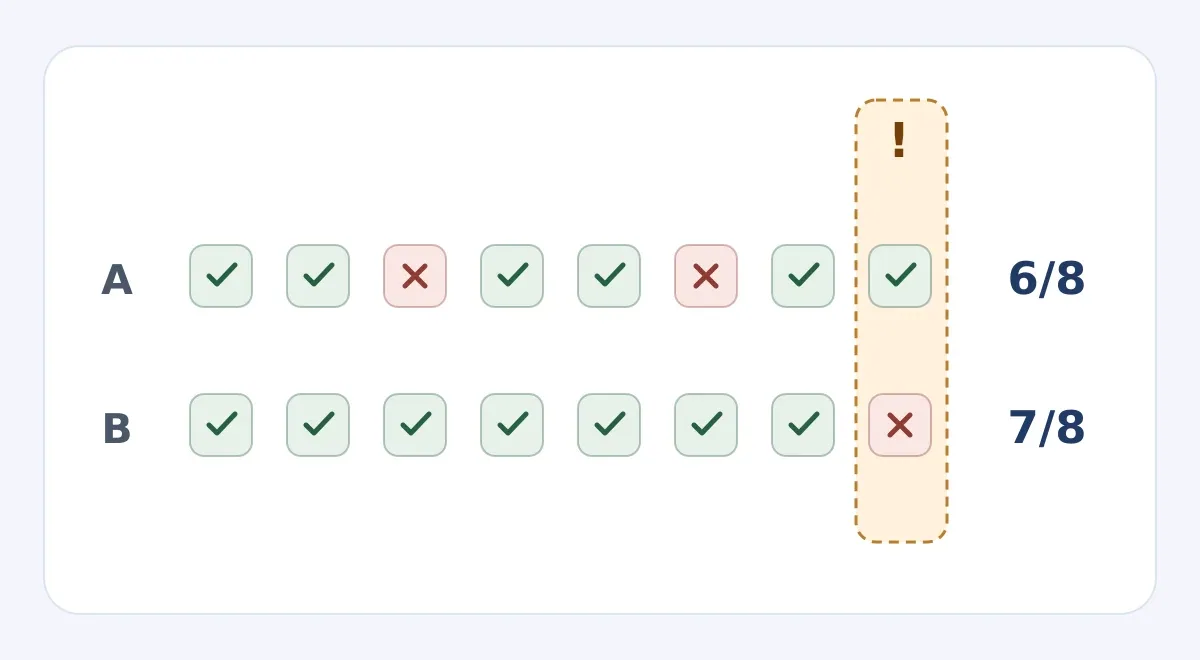
虚构示意,非产品界面或实测结果。虚线框是团队预先指定的关键用例:没有退款确认时,不得声称退款已经完成。B 的总通过数更高,仍由复核人退回。
用一次复核交接决定要不要引入平台
让没参与修改的人找到这条失败用例,核对新旧回答,再利用版本差异和运行链路定位问题出在哪里。如果链路记录只显示结果,没有需要的中间信息,不能把「有追踪」当成「能解释错误」。先检查测试数据与链路字段哪些允许存储;试用只用合成输入,不把客户原文或生产密钥放进去。确认能找到上一版配置,并在测试环境演练恢复;回退提示词版本不代表撤销已执行的外部操作。
最后记录定位与交接省下的工时,扣除维护测试集和新增人工复核投入。估算模型预算时,假设同一批 8 条用例、2 个版本各跑 3 轮,一共生成 48 份草稿;如果每份再用模型判分,还要另算 48 次判分调用。轮数仅是测算假设,不是可靠性保证,关键用例仍由人复核。模型生成和判分可能是旧流程也要付的费用,单独列出保留的共同成本,再比较新工具的额外平台、接入或自托管运维开支。
Agenta 的开源公告将评估、提示词管理和可观测性列为核心开源功能,将部分高级协作能力(如角色权限、单点登录与审计日志)单独授权;自托管不能替代对所需治理功能的确认。只有关键用例能守住、其他人能追溯已有输入和结果,且节省的工时价值能覆盖额外成本,才值得扩大。若差错主要来自测试集没有覆盖真实风险,先补测试集,比换工具更有效。
内容说明:本文基于公开资料整理,仅供工具选型参考。产品功能、价格及相关政策可能随时调整,请以官方最新信息为准。
原文出处:www.agenta.ai