Analyzr 选用指南:预测表能导入,不代表用了当时可知的数据
Analyzr 已改用 G2M 品牌。它适合有重复预测需求、能维护一致输入的团队;选用前用虚构活动验清索引、预测目标与截止时点,别把同名字段通过检查误当成没有未来信息泄漏。
为反复举办的小型产品说明会估算资料份数,团队可能不想每次都重新写模型代码。Analyzr 的无代码预测路线有价值,但采购门槛不是“CSV 能上传、结果能导出”,而是下一场活动还能按同一口径提供输入。Analyzr 官方已改用 G2M 品牌,查功能和交付范围应看 G2M Platform,而不是把旧工具名称当作另一套独立服务。
G2M 的变量指南把字段分成不同角色:自变量是预测输入,回归的因变量是数值目标,索引则用于在导入、训练和预测中识别记录。类型无法自动识别时需要手动指定。对于活动估算,这意味着活动编号 E17 用来把结果接回原记录,实际到场人数是待预测的目标,提前已知的报名情况才可能成为输入。编号能对账,不代表应把编号当成预测依据;字段类型正确,也不能证明它在决策时已经可用。
同一个列名,可能装着两个时点的数据
先用完全虚构的材料检查:活动 E17 在举办前七天有120人报名,活动当天最终报名150人,实际到场96人。若团队在提前七天决定印多少份资料,输入可以包含当时的120,却不能偷看之后的150。整理历史训练表时,活动结束后记录的96可以作为预测目标;它同样不能混进提前七天的输入。这里不是在运行模型或断言这些字段足够预测,只是在明确每个值什么时候才可知。
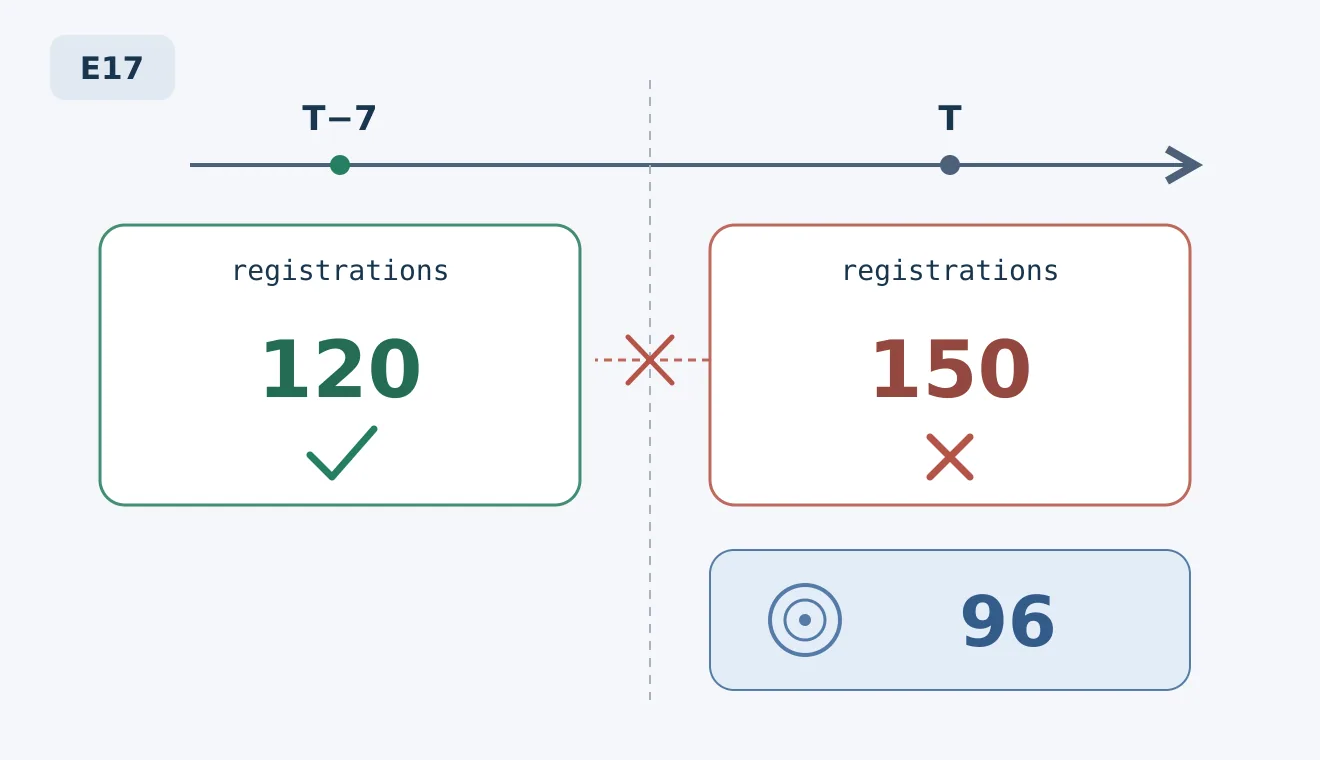
原创虚构算例,非 Analyzr 或 G2M 的模型输出。T为活动日;120与150都可能被写进名为 registrations 的列,但可用时点不同。实际到场96是历史活动的训练目标,不是提前七天可用的输入。
G2M 的现有模型预测说明要求 CSV 包含训练时选定的相同变量,列名一致;额外未使用的列可以存在,缺少必需变量会报错。这能帮助发现结构不匹配,却不能替团队识别时间含义。如果训练表的 registrations 是最终报名150,而下一场活动的同名列是提前七天的120,两个文件可能列名相同、含义却不一致。验收应把“提前七天截取报名快照”写成明确的数据交付条件,并在若干虚构行里故意放入晚到的值,检查预处理如何发现或阻止它,而非假定平台会自动拦截。
先把结果接回活动,再比较有没有必要上平台
官方说明支持在 Predict 中载入 CSV、查看结果并导出;源系统持续调用的机器间预测则需联系客户代表或支持团队。采购时应区分人工每批导入与自动持续运行,不能因为能导出结果就把接口接入、更新频率和运维都算作已经包含。先用虚构编号核对导出后的预测对应哪场活动、哪次输入快照和哪个模型版本。不要依赖行序碰巧不变,也不要把示意数据演练当成模型效果验证。
效果评估要另外做:只在过去的训练记录中确定模型与简单基线,例如用此前同类活动的到场比例乘以提前七天报名数,再用未参与选择的较晚活动比较误差。两者都只能用同一截止时点已知的输入。比较少印与多印造成的返工和浪费,而不只看一个漂亮的总误差;这属于团队要设计的验收,不是已证实的平台默认验证方式。若样本很少、活动口径常变,先用表格记录快照和实际结果通常比加一个平台更务实。
值得购买的条件是这种预测会重复发生,团队能负责输入快照与异常处理,而且平台节省的建模、交接时间足以覆盖报价中的使用、连接配置与持续维护成本。请供应方明确 CSV 批处理、持续预测接入和版本追溯分别交付什么,再与现有表格流程比较。只有结果能按编号回查、训练与预测输入的时间含义一致,误差比较也通过预先约定的门槛,才考虑扩大使用。本文的虚构活动只用于资料准备,不用于人员资格、金融或其他高影响决策。
内容说明:本文基于公开资料整理,仅供工具选型参考。产品功能、价格及相关政策可能随时调整,请以官方最新信息为准。
原文出处:g2m.ai