Anam 选用指南:同一个数字人,什么时候做成视频就够了?
固定迎新说明用文字或脚本 MP4 即可。只有访客补充信息后,下一步确实会改变,才值得评估 Anam 实时数字人,并把答不出来、拒绝麦克风和长期成本一起纳入验收。
团队想在网页上放一位迎新角色,先问一句:访客告诉它更多信息以后,会得到不同的指引吗?如果每个人都需要同一段开放说明,一页文字可能已经足够;如果需要统一的视听呈现,再比较 Anam 的脚本视频。只有当补充信息确实会改变下一步,而且已有可靠的分流规则时,才值得把同一个角色做成实时数字人。
复用角色,不等于复用对话
Anam 的 Avatar Videos API 把提交的脚本异步渲染成可下载的 MP4,不启动互动会话。可以直接选择头像和声音,也可以复用已保存的角色。用后一种方式时,视频继承角色的头像、声音、语言、头像模型和导演备注,但只朗读提交的脚本,不会运行角色的开场问候、对话模型、提示词或工具。这意味着,就算保存的角色原本会先问场次,做成视频后也不会自动多问一句。编辑要把观众必须知道的信息明确写进脚本,并准备一份可独立使用的文字说明。
想象一个完全虚构的展馆。网站只需告诉每位访客“先看场次表,再按表内指引入场”,文字和脚本 MP4 都能交付同一条信息。若来访者问“C 厅怎么走”,而事先批准的示例规则是日场从东门走、夜场从南门走,追问“你参加哪一场?”才会改变指引。若访客不清楚场次或问到了规则没有覆盖的情况,就给出同一份场次表,而不是猜一个入口。这里的地点、规则、形象和声音均按虚构、合成且不拟仿真人设计,只是未实测的验收设想。
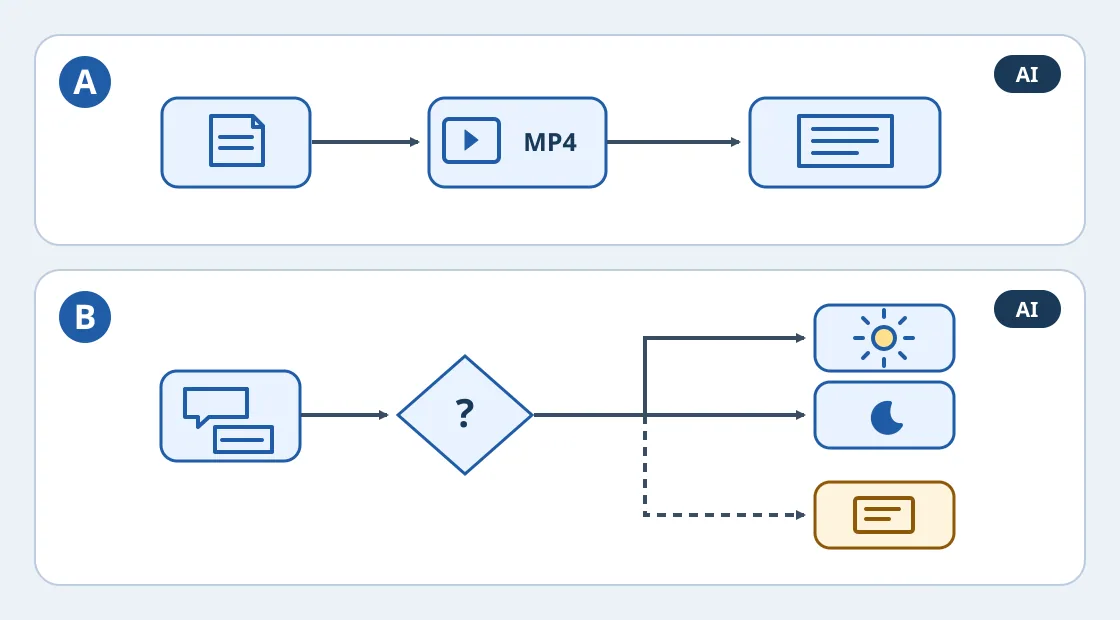
原创采购验收示意,不是 Anam 界面或实测结果。A 用同一虚构角色呈现固定脚本,复用外观和声音不等于执行其对话模型和工具。B 只有在澄清会改变下一步时才考虑实时;无法澄清时使用文字退路。两条路径都应明确标识 AI。A 末端的文字图标指团队另行准备的同页说明,并非 MP4 自动产出的文字。
把实时方案和文字分流放在同一轮验收
先做不含人像的对照:同一页文字放两个明确选项,让访客自己选日场或夜场。再对照拟议的脚本视频与实时方案。固定信息看能否在同一页面读到或听到;有分支的问题看澄清后能否走对;不在范围内的问题看系统能否承认不知道并回到文字;拒绝麦克风、没有声音或会话未连上时,文字指引仍要可用。记录的是从页面打开到拿到正确指引的时间,不是第一帧多快出现。若两个文字选项已能可靠解决分流,就不必为同一结果维护一套实时会话。
还要检查用户是否知道自己面对的是 AI。Anam 的发布说明区分了厂商控制的体验与自建集成:Lab 会话和分享链接包含持续可见的 AI 标识,而 JavaScript、Python SDK 和 LiveKit 集成可选择开启厂商标识,不能假定自建界面已经显示。给脚本视频也在播放前后保留清楚的 AI 说明和文字入口,这是此处的验收标准,不是已验证的 MP4 默认功能。只在另行批准的演示条件下,用虚构输入核对,不接真实名单、账户或外部操作工具;脚本视频不执行角色工具这一点,也不能推导出互动方案天然隔离。
按同一批访客的完整成本比较
采购先问谁负责更新指引。场次一变,纯文字可改现有页面;固定视频要考虑改脚本、重渲染、替换成片和校对字幕。实时方案也不能省去更新规则,还需要核对会话用量、并发限制、集成及持续复核。向厂商分开确认渲染、重做和会话各如何计费,不要把视频成片时长和会话分钟混做同一账单。比较时用同一批假设访客、同一套指引,核算到达正确结果的维护和运行成本,而不是只比哪种数字人更像在交谈。
最终的选用门槛可以写得很直接:固定内容先选可维护的文字,只有确需统一视听呈现时再做脚本 MP4;只有追问能减少走错路,而且文字分流做不到同样可靠,实时才进入下一轮。若异常回不到文字、AI 标识看不清或完整费用没有核清,就先保持简单方案。
内容说明:本文基于公开资料整理,仅供工具选型参考。产品功能、价格及相关政策可能随时调整,请以官方最新信息为准。
原文出处:anam.ai