BestLLMfor 选用指南:先算两种上下文的显存余量,再挑本地模型
把公开规格变成候选清单,而不是装机保证。用两组虚构预算区分模型文件、上下文和运行开销,避免只看模型大小做决定。
把它当成筛选表,不当跑分
BestLLMfor 2026 年 8 月的显卡选型指南先按显存档位挑候选,再按具体模型与量化版本细查。它的量化说明还把模型权重和随上下文增长的 KV 缓存分开。这样的拆分适合给同类文本模型做初筛,不等于你机器上的兼容性、速度或回答质量已经过关。别把模型最大上下文和这台机器实际能承担的上下文混为一谈。
同一模型,用两张纸算预算
用一台虚构电脑演算:标称显存 8 GB 的卡,给系统和其他程序留出 1 GB,这次只预算 7 GB。候选 A 固定为同一个量化版本,纸面假设权重占 5 GB,运行开销 0.5 GB。短输入的缓存假设 0.8 GB,总计 6.3 GB,余量 0.7 GB;长输入的缓存假设 2 GB,总计 7.5 GB,超预算 0.5 GB。数字只为解释判断,不是任何真实模型或硬件的规格。
拿另一个同类文本模型候选 B 来比较时,用相同输入长度、输出预算与运行环境,分别记录 A 和 B 的量化版本;不要用 A 的短输入对 B 的长输入。第一次筛选应能指出 A 在短输入预算内、长输入不在,并说明下一步可比较较轻的量化版本、缩短文档或换更小的同类模型,而不是据此宣称哪个模型更聪明。
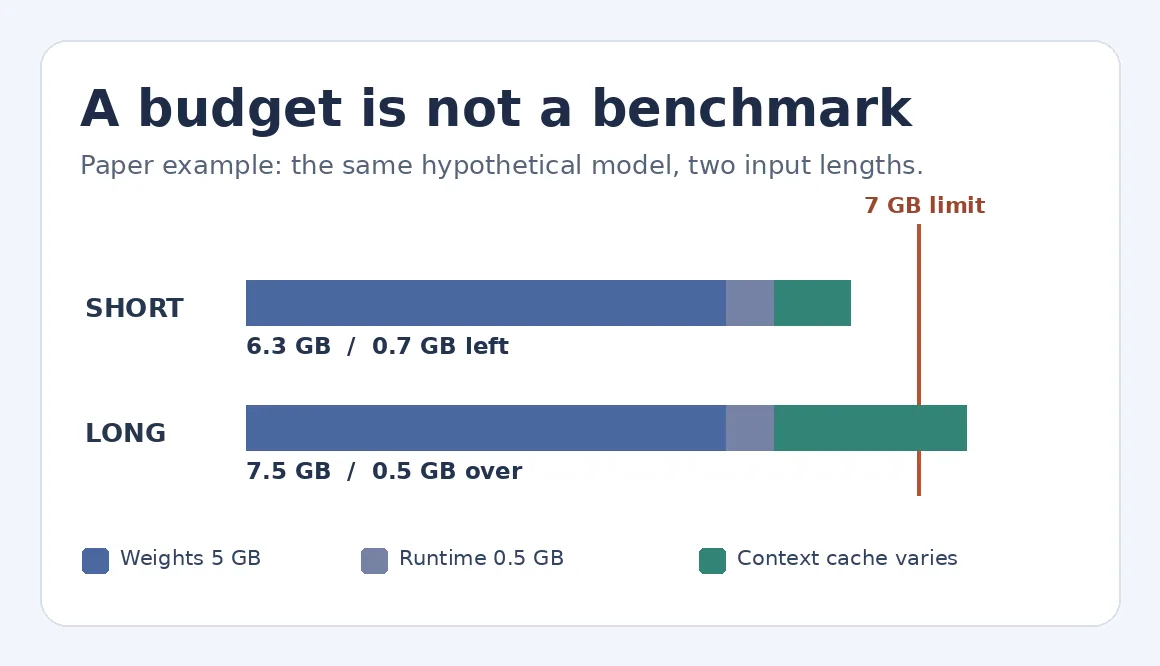
原创纸面示意。权重和运行开销保持不变,只有上下文缓存变化;超过预算不等于已经测过性能。
什么时候别用它下决定
模型、框架或量化版本标注不清,就别把页面估算拿去做采购依据。若任务常是很短的纯文本,而现有方案已经够快,简单的工具可能比再管理一套本地模型省事。若必须长文处理,则把剩余显存、答对自制样张的比例以及等待时间作为不同验收项;自写一份虚构目录,准备几条有答案的查找题,并预先决定最多愿意等多久。估算只负责把候选缩小到值得进一步验证的范围,本例不下载模型、不运行软件。
内容说明:本文基于公开资料整理,仅供工具选型参考。产品功能、价格及相关政策可能随时调整,请以官方最新信息为准。
原文出处:bestllmfor.com